दस्तावेज़ निष्कर्षण सॉफ़्टवेयर
वित्त टीमों के लिए एआई का उपयोग करके दस्तावेज़ तालिकाओं और फ़ील्ड्स को निकालें
के साथ शुरू
दस्तावेज़ पुस्तकालय
इसके लिए काम करें
नामित फ़ील्डों के लिए दस्तावेज़
उदाहरण स्रोत
दस्तावेज़ पुस्तकालय
- दस्तावेज़ फ़ील्ड
- विक्रेता का नाम, चालान संख्या, जारी करने की तिथि, कुल राशि
- तालिका शीर्षांक
- पंक्ति संख्या, वस्तु विवरण, मात्रा, इकाई मूल्य, पंक्ति योग
- पंक्तियों को दोहराना
- प्रत्येक लेनदेन या मद के लिए एक मानकीकृत रिकॉर्ड
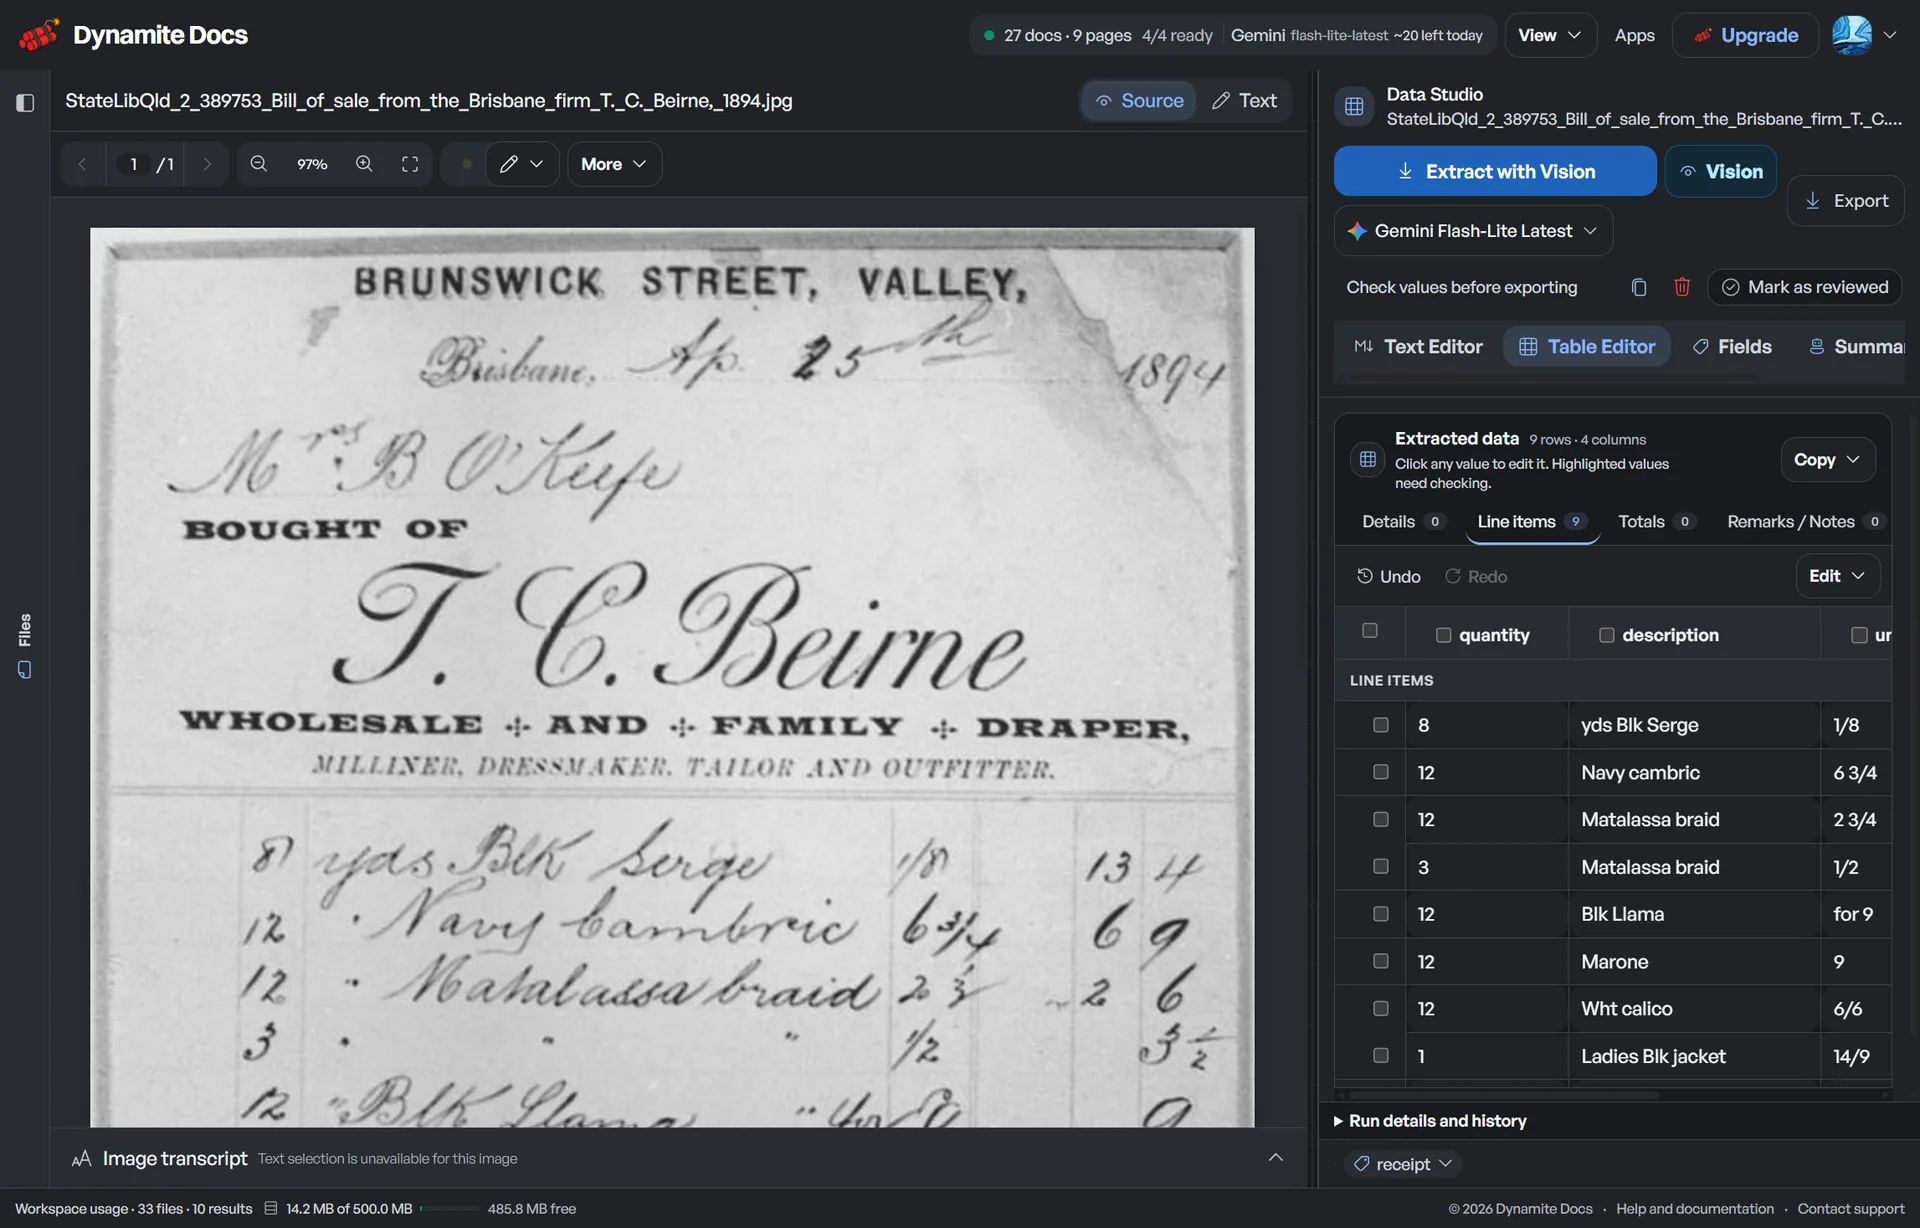
प्रत्येक फ़ाइल की उसके परिणाम के साथ समीक्षा करें।
व्यापारिक दस्तावेजों के ढेर को संरचित पंक्तियों में बदलें, फिर एक्सेल, आपके लेखा प्रणाली या एपीआई तक पहुंचने से पहले संख्याओं की जांच करें।
मैन्युअल डेटा एंट्री शायद ही कभी किसी एक फ़ील्ड में टाइप करने में कठिनाई के कारण कठिन होती है। यह कठिन इसलिए होती है क्योंकि फ़ाइलें अलग-अलग लेआउट में आती हैं, टेबल अगले पेज पर जारी रहती हैं और एक गलत अंक पूरे डेटासेट को खराब कर सकता है। डायनामाइट डॉक्स उपलब्ध होने पर एम्बेडेड टेक्स्ट को पढ़ता है और स्कैन किए गए या केवल इमेज वाले पेजों के लिए विज़न-कैपेबल मॉडल का उपयोग करता है।
दस्तावेज़ निष्कर्षण वर्कस्पेस OCR टेक्स्ट के लंबे ब्लॉक के बजाय नामित फ़ील्ड और टेबल पंक्तियाँ लौटाता है। आप अनिश्चित मानों की तुलना मूल दस्तावेज़ से कर सकते हैं, उन्हें वहीं ठीक कर सकते हैं और समान लेआउट पर सहेजे गए सुधारों का पुनः उपयोग कर सकते हैं। परिणाम तैयार होने पर, इसे Excel, CSV, JSON, Google Sheets, वेबहुक या REST API पर भेजें।
दस्तावेज़ को निःशुल्क निकालें । ब्राउज़र में ही शुरू करें, क्रेडिट कार्ड की आवश्यकता नहीं है। डाउनलोड करने या निकाले गए दस्तावेज़ को अपने पास रखने के लिए साइन अप करें।
आपके पास पहले से मौजूद स्रोत फ़ाइल का उपयोग करें
- डिजिटल पीडीएफ: सबसे पहले मौजूदा टेक्स्ट लेयर का उपयोग करें, फिर फ़ील्ड और टेबल को दोबारा टाइप किए बिना व्यवस्थित करें।
- स्कैन की गई फाइलें और रसीदें: एआई ओसीआर का उपयोग करके छवि-आधारित पृष्ठों को पढ़ें, साथ ही समीक्षा के लिए पृष्ठ लेआउट को भी उपलब्ध रखें।
- बहु-पृष्ठ पैकेट: तालिकाओं को पृष्ठ विरामों के पार ले जाएं, दोहराए गए शीर्षकों को हटा दें और जांच के लिए पृष्ठ संदर्भों को बनाए रखें।
- मिश्रित व्यावसायिक दस्तावेज़: चालान, विवरण, खरीद आदेश और अन्य व्यावसायिक फ़ाइलों को एक ही कार्यक्षेत्र में संसाधित करें।
OCR टेक्स्ट डंप के बजाय फ़ील्ड और पंक्तियाँ प्राप्त करें।
दस्तावेज़-स्तर के मान दोहराए जाने वाले रिकॉर्ड से अलग रहते हैं। इससे समीक्षकों को एक उपयोगी योजना मिलती है और आगे की प्रणालियों को अनुमानित कॉलम मिलते हैं।
- दस्तावेज़ फ़ील्ड: विक्रेता का नाम, चालान संख्या, जारी करने की तिथि, कुल राशि
- तालिका शीर्षक: पंक्ति संख्या, वस्तु विवरण, मात्रा, इकाई मूल्य, पंक्ति योग
- पंक्तियों की पुनरावृत्ति: प्रति लेनदेन या लाइन आइटम एक मानकीकृत रिकॉर्ड
- दिनांक और मुद्राएँ: मानकीकृत आईएसओ दिनांक और स्पष्ट संख्यात्मक मुद्रा मान
- स्रोत निर्देशांक: निकाले गए मानों को पृष्ठ स्थानों से जोड़ने वाले परिबद्ध बॉक्स
- आत्मविश्वास स्कोरिंग: समीक्षा के लिए सेल-स्तर और क्षेत्र-स्तर के आत्मविश्वास संकेतक
फ़ाइल से लेकर समीक्षित परिणाम तक
- 1. मूल फ़ाइलें जोड़ें। डिजिटल पीडीएफ, स्कैन, इमेज या समर्थित ऑफिस फ़ाइलें अपलोड करें। एपीआई क्लाइंट प्रोग्रामेटिक रूप से संग्रहीत दस्तावेज़ सबमिट कर सकते हैं।
- 2. दस्तावेज़ को स्कीमा परिभाषित करने दें। एआई दस्तावेज़ निष्कर्षण प्रत्येक लेआउट के लिए समन्वय टेम्पलेट के बिना कुंजी-मान फ़ील्ड, तालिकाओं और दोहराई जाने वाली पंक्तियों की पहचान करता है।
- 3. परिणाम की तुलना स्रोत से करें। दस्तावेज़ के बगल में चिह्नित फ़ील्ड की समीक्षा करें, मानों को सही ढंग से दर्ज करें और समान फ़ाइलों के लिए उपयोगी फ़ील्ड मैपिंग सहेजें।
- 4. समीक्षा किए गए डेटा को उसके सही स्थान पर भेजें। एक्सेल, सीएसवी या JSON फ़ाइल डाउनलोड करें, Google शीट्स में एक टेबल अपलोड करें, या वेबहुक और REST API के माध्यम से परिणाम भेजें।
प्रत्येक सुधार के साथ स्रोत का उल्लेख अवश्य रखें।
समीक्षा कार्यक्षेत्र दस्तावेज़ को निकाली गई तालिका के बगल में रखता है। चिह्नित सेल खोलें, उसकी तुलना पृष्ठ से करें और पीडीएफ व्यूअर और स्प्रेडशीट के बीच स्विच किए बिना मान को ठीक करें।


ऐसा आउटपुट चुनें जिसे आपका अगला सिस्टम उपयोग कर सके।
एक बार समीक्षा किए गए एक्सट्रैक्शन को वर्कबुक, फ्लैट इंपोर्ट फाइल, स्ट्रक्चर्ड JSON या शेयर्ड गूगल शीट में बदला जा सकता है।
| प्रारूप | डेटा संरचना | उपयोगी जब |
|---|---|---|
| एक्सेल (.xlsx) | दस्तावेज़ फ़ील्ड और लाइन आइटम के साथ मल्टी-टैब वर्कबुक | वित्तीय मॉडलिंग, मिलान और लेखापरीक्षा |
| सीएसवी | मानकीकृत कॉलम हेडर वाली सपाट सारणीबद्ध पंक्तियाँ | ईआरपी डेटा आयात, डेटा लेक और स्प्रेडशीट विश्लेषण |
| जेएन | निर्देशांक डेटा के साथ संरचित वस्तुएं और टाइप किए गए सरणियाँ | स्वचालित एपीआई, बैकएंड पाइपलाइन और क्लाउड वर्कफ़्लो |
| गूगल शीट्स | समर्पित दस्तावेज़ टैब के साथ लाइव शीट निर्यात | सहयोगात्मक टीम समीक्षा और परिचालन ट्रैकिंग |
आत्मविश्वास को समीक्षा के संकेत के रूप में लें, गारंटी के रूप में नहीं।
आत्मविश्वास
विश्वास स्कोर आपको यह तय करने में मदद करते हैं कि पहले कहां देखना है। उच्च स्कोर होने पर भी, धन, कर पहचानकर्ता, खाता विवरण और भुगतान तिथियों की पुष्टि स्रोत से करें।
शुद्धता
एक विश्वसनीय टेक्स्ट लेयर विज़ुअल कैरेक्टर रिकग्निशन की समस्या को दूर करती है। स्कैन और फ़ोटो में धुंधलापन, टेढ़ापन, संपीड़न और प्रकाश संबंधी समस्याएं आ जाती हैं, जिनकी बारीकी से समीक्षा करना आवश्यक है।
विफलता की स्थिति
पासवर्ड से सुरक्षित फाइलें, क्षतिग्रस्त पीडीएफ और अस्पष्ट स्कैन एक्सट्रैक्शन से पहले विफल हो सकते हैं या अपूर्ण डेटा उत्पन्न कर सकते हैं। उपलब्ध सबसे साफ मूल फ़ाइल का उपयोग करें।
उत्पाद सीमा
डायनामाइट डॉक्स फ़ील्ड और टेबल निकालता है। यह मूल दस्तावेज़ के दृश्य डिज़ाइन, लोगो या पृष्ठ संरचना को पुनः निर्मित नहीं करता है।
यह जानें कि सॉफ्टवेयर क्या जांचता है और समीक्षक किस चीज का मालिक है।
प्लेटफ़ॉर्म फ़ाइल तैयार करता है और परिणाम को संरचित करता है। आपके नियम और समीक्षक तय करते हैं कि वह परिणाम उपयोग के लिए सुरक्षित है या नहीं।
| सिस्टम परत | द्वारा संभाला गया | बेसिक कार्यक्रम |
|---|---|---|
| दस्तावेज़ अंतर्ग्रहण | डायनामाइट डॉक्स | टेक्स्ट एक्सट्रैक्शन, इमेज रैस्टराइज़ेशन, पेज स्प्लिटिंग और लेआउट हैशिंग |
| स्कीमा अनुमान | एआई प्रदाता (होस्टेड या बीयोक) | दस्तावेज़ फ़ील्ड, तालिका शीर्षलेख और दोहराई जाने वाली पंक्ति मदों का प्रस्ताव करता है |
| डेटा सत्यापन | मानव समीक्षक और नियम इंजन | विश्वास स्कोरिंग, गणितीय सामंजस्य और अंतिम स्वीकृति |
| डाउनस्ट्रीम डिलीवरी | एकीकरण और एपीआई | Excel, CSV, Google Sheets, वेबहुक और REST एंडपॉइंट्स पर निर्यात करें |
गोपनीयता, सुरक्षा और डेटा निवास नियंत्रण
निःशुल्क और गुमनाम फाइलें ब्राउज़र स्टोरेज में रहती हैं, लेकिन होस्टेड एक्सट्रैक्शन तैयार दस्तावेज़ की सामग्री को एक योग्य एआई प्रदाता को भेजता है। सशुल्क प्लान में एन्क्रिप्टेड क्लाउड फाइल स्टोरेज की सुविधा मिलती है।
प्रत्येक लॉग-इन स्तर एक एआई प्रदाता कुंजी को कनेक्ट कर सकता है। हॉबी, प्रो और अल्ट्रा स्तर उपयोगकर्ता के कंप्यूटर पर मॉडल अनुमान के लिए स्थानीय ओलामा साथी का उपयोग कर सकते हैं।
दस्तावेज़ निष्कर्षण सॉफ़्टवेयर के बारे में प्रश्न
डॉक्यूमेंट एक्सट्रैक्शन सॉफ्टवेयर क्या है और यह कैसे काम करता है?
दस्तावेज़ निष्कर्षण सॉफ़्टवेयर PDF, स्कैन और छवियों से टेक्स्ट और लेआउट पढ़ता है, फिर नामित फ़ील्ड और टेबल पंक्तियाँ प्रस्तावित करता है। डायनामाइट डॉक्स में, आप एक्सेल, CSV या JSON में निर्यात करने से पहले उस परिणाम की तुलना मूल फ़ाइल से करते हैं।
एआई द्वारा दस्तावेज़ निष्कर्षण पारंपरिक टेम्पलेट ओसीआर से किस प्रकार भिन्न है?
परंपरागत OCR कठोर समन्वय क्षेत्रों पर निर्भर करता है जो विक्रेता द्वारा लेआउट में बदलाव करने पर टूट जाते हैं। AI दस्तावेज़ निष्कर्षण बहुआयामी मॉडलों का उपयोग करता है जो दृश्य संदर्भ और अर्थपूर्ण अर्थ को समझते हैं, और विभिन्न लेआउट में सटीक रूप से डेटा निकालते हैं।
क्या मैं बहु-पृष्ठीय दस्तावेज़ों और निरंतर तालिकाओं से डेटा निकाल सकता हूँ?
जी हां। एक्सट्रैक्शन लगातार पंक्तियों को जोड़ सकता है और दोहराए गए हेडर को हटा सकता है। प्रत्येक पेज ब्रेक की समीक्षा करें क्योंकि रैप की गई पंक्तियाँ, उप-योग और लेआउट परिवर्तन अभी भी रिकॉर्ड को विभाजित या डुप्लिकेट कर सकते हैं।
मैं डायनामाइट डॉक्स के साथ दस्तावेज़ निष्कर्षण के लिए किन एआई प्रदाताओं का उपयोग कर सकता हूँ?
प्रबंधित होस्टेड मॉडल का उपयोग करें, अपनी स्वयं की प्रदाता कुंजी कनेक्ट करें, या Microsoft Store कंपेनियन के माध्यम से स्थानीय मॉडल इन्फ़रेंस चलाएँ। अपने Windows PC पर Ollama को कनेक्ट करें और समीक्षा और निर्यात के लिए अपने ब्राउज़र वर्कस्पेस का उपयोग करें। वर्कस्पेस और साइन-इन सेवाओं के लिए इंटरनेट एक्सेस आवश्यक है।
अगला दस्तावेज़ कार्य चुनें
- AI द्वारा PDF डेटा को Excel और CSV में निकालना : PDF फ़ाइलों से संरचित तालिकाओं, पंक्ति मदों और मेटाडेटा को निकालना।
- संरचित डेटा के लिए एआई पीडीएफ निष्कर्षण : डिजिटल या स्कैन किए गए पीडीएफ पढ़ें, फिर स्रोत के साथ-साथ फ़ील्ड और तालिकाओं की समीक्षा करें।
- ओसीआर सॉफ्टवेयर और गाइड : ओसीआर गाइड, वर्कफ़्लो और टूल की हमारी पूरी लाइब्रेरी देखें।
- पीडीएफ से एक्सेल कन्वर्टर : पीडीएफ टेबल को दोबारा टाइप किए बिना संरचित स्प्रेडशीट में बदलें।
- दस्तावेज़ निष्कर्षण REST API : दस्तावेज़ जमा करें और प्रोग्रामेटिक रूप से संरचित परिणाम प्राप्त करें।
- निजी दस्तावेज़ एआई नियंत्रण : केवल ब्राउज़र-आधारित संग्रहण, प्रदाता प्रशिक्षण शर्तों और BYOK सुरक्षा की समीक्षा करें।
- दस्तावेज़ निष्कर्षण मूल्य निर्धारण : होस्टेड और BYOK प्रोसेसिंग के साथ फ्री, हॉबी, प्रो और अल्ट्रा स्तरों की तुलना करें।
संबंधित वर्कफ़्लो
किसी दस्तावेज़ को निःशुल्क निकालें या प्रसंस्करण, भंडारण और एकीकरण सीमाओं की तुलना करें ।
के साथ शुरू
दस्तावेज़ पुस्तकालय
इसके लिए काम करें
नामित फ़ील्डों के लिए दस्तावेज़
- 01 मूल फ़ाइलें जोड़ें
- 02 दस्तावेज़ को स्कीमा परिभाषित करने दें
- 03 परिणाम की स्रोत से तुलना करें
- 04 समीक्षा किए गए डेटा को उसके संबंधित स्थान पर भेजें
के साथ शुरू
दस्तावेज़ पुस्तकालय
इसके लिए काम करें
नामित फ़ील्डों के लिए दस्तावेज़
उदाहरण स्रोत
दस्तावेज़ पुस्तकालय
- दस्तावेज़ फ़ील्ड
- विक्रेता का नाम, चालान संख्या, जारी करने की तिथि, कुल राशि
- तालिका शीर्षांक
- पंक्ति संख्या, वस्तु विवरण, मात्रा, इकाई मूल्य, पंक्ति योग
- पंक्तियों को दोहराना
- प्रत्येक लेनदेन या मद के लिए एक मानकीकृत रिकॉर्ड
प्रत्येक फ़ाइल की उसके परिणाम के साथ समीक्षा करें।